

Il 15 maggio 2026 Google ha pubblicato la sua prima guida ufficiale per l’ottimizzazione nelle funzionalità AI di Search. Tra i “miti da sfatare”, un passaggio molto chiaro: non è necessario creare nuovi file leggibili a macchina, file di testo AI, markup o Markdown per apparire su Google Search, incluse le sue funzionalità di AI generativa, perché Google Search non li utilizza. Il file llms.txt non influenza né positivamente né negativamente la visibilità o il ranking.
Dichiarazione netta. Fonte ufficiale. Eppure, pochi giorni prima di quella guida, in PageSpeed Insight aveva aggiunto una nuova categoria di audit chiamata “Navigazione agentica” e uno dei tre controlli che valuta è esattamente la presenza e la corretta implementazione del file llms.txt.
Non è un errore. Non è una contraddizione. È la stessa azienda che risponde a due domande diverse, con due prodotti diversi, rivolti a due scenari d’uso distinti. Ma per chi legge dall’esterno e soprattutto per chi deve decidere se implementare o no questo file la situazione sembra quanto meno ambigua.
In questo articolo proviamo a fare chiarezza partendo dalle fonti primarie, non dalle opinioni. Vedremo cos’è il file llms.txt e da dove viene, cosa dice Google ufficialmente attraverso John Mueller e la guida Search Central, e cosa sta invece implementando nei suoi strumenti di diagnosi (PageSpeed Insights, Chrome Lighthouse, e il prossimo pannello AI di Search Console). Spiegheremo cosa sono la navigazione agentica, l’albero di accessibilità e il Cumulative Layout Shift i tre requisiti che Lighthouse ora misura e perché questi concetti, nati nel mondo della SEO tecnica, stanno diventando infrastruttura per gli agenti AI.
Infine, mostreremo un caso reale: il sito di un fotografo wedding che raggiunge 100/100 su PageSpeed e 3/3 sulla navigazione agentica, e come il lavoro di ottimizzazione tecnica e dei dati strutturati che abbiamo condotto si riflette direttamente su quei risultati.
La risposta alla domanda del titolo, anticipata: Google non si sta contraddicendo. Sta costruendo due layer separati uno per la Search, uno per gli agenti e il file llms.txt appartiene al secondo. Capire questa distinzione oggi significa essere pronti per il web che sta arrivando.
Cos’è il file llms.txt
Il 3 settembre 2024 Jeremy Howard, co-fondatore di Answer.AI e fast.ai, ricercatore AI e docente alle università del Queensland e di Stanford, pubblicò la sua proposta su answer.ai e llmstxt.org. L’idea era semplice quanto il problema che voleva risolvere.
Howard aveva osservato un limite pratico: le context window dei modelli linguistici sono troppo piccole per gestire la maggior parte dei siti web nella loro interezza. Quando un sistema AI tenta di elaborare contenuti web, si trova di fronte a strutture HTML complesse (menu di navigazione, advertising, codice JavaScript) che consumano spazio prezioso senza fornire informazioni utili. Il risultato è un modello che spreca token su elementi irrilevanti prima ancora di raggiungere il contenuto che conta.
Il progetto di riferimento era FastHTML, il suo framework Python con documentazione tecnica: esattamente il caso d’uso per cui l’idea era stata progettata. Non ottimizzazione SEO, non ranking ma un’interfaccia pulita tra un sito e gli strumenti AI che lo consultano in fase di inferenza.
La proposta definisce due file distinti, la cui specifica ufficiale è pubblicata su llmstxt.org:
- /llms.txt — un file Markdown alla root del dominio che fornisce un indice curato delle pagine più importanti del sito, con descrizioni sintetiche. È la mappa per i modelli linguistici.
- /llms-full.txt — un file opzionale che contiene il contenuto completo delle pagine linkate in un unico documento, per un’ingestione più profonda da parte degli agenti AI.
La struttura minima richiesta dalla specifica è intenzionalmente essenziale: un’intestazione H1 con il nome del sito, un sommario descrittivo, e sezioni con link annotati. Lighthouse, come vedremo, verifica proprio questi requisiti minimi.
La diffusione rimase di nicchia per i primi mesi. Il punto di svolta arrivò a novembre 2024, quando Mintlify, piattaforma di hosting per documentazione tecnica, aggiunse il supporto nativo al file su tutti i siti ospitati. Praticamente dall’oggi al domani, migliaia di siti di documentazione, tra cui quelli di Anthropic e Cursor, acquisirono il file. Da quel momento l’adozione si estese progressivamente anche oltre il mondo della documentazione per sviluppatori, raggiungendo CMS come Yoast e Rank Math, e piattaforme e-commerce come Shopify.
Vale la pena chiarire cosa llms.txt non è: non è un’alternativa a robots.txt, non controlla l’accesso dei crawler, non è un segnale di ranking per Google Search. È un content manifest, una mappa ragionata dei contenuti più importanti del sito per i modelli linguistici da consultare in tempo reale, non durante la fase di addestramento. La distinzione tra inferenza e training è centrale per capire a cosa serve davvero.
Cosa dice Google ufficialmente
La posizione ufficiale di Google sul file llms.txt è scritta nero su bianco nella guida Search Central pubblicata il 15 maggio 2026 su developers.google.com. Il passaggio dedicato è inserito in una sezione esplicitamente intitolata ai “miti da sfatare”:
“Non è necessario creare nuovi file leggibili a macchina, file di testo AI, markup o Markdown per apparire su Google Search, incluse le sue funzionalità di AI generativa, perché Google Search non li utilizza. È del tutto accettabile creare e mantenere file llms.txt per altri servizi o sistemi che li utilizzano. Farlo non influenzerà né positivamente né negativamente la tua visibilità o il tuo ranking su Google Search, poiché Google Search li ignora.”
Nessuna ambiguità. Ma la dichiarazione ha generato subito una domanda scomoda: se llms.txt non serve, perché alcune proprietà di Google stessa, come le pagine di documentazione per sviluppatori, pubblicano il file?
La risposta è arrivata da John Mueller su Bluesky, in un thread avviato da Lily Ray. Mueller aveva risposto alla domanda di Lily Ray, che chiedeva perché Google pubblica file llms.txt e pagine Markdown nonostante dichiari che non sono necessari per la Search, con una distinzione fondamentale: “La risposta breve è che non è fatto per la Search. Nei siti web c’è più della sola SEO. La versione più lunga e sfumata è che vale la pena separare la ‘discovery‘ (trovare il sito o le pagine tramite un motore di ricerca globale) dalla ‘functionality‘ (una volta trovata la pagina, aiutare l’utente a completare nel modo migliore il task che vuole fare.)”
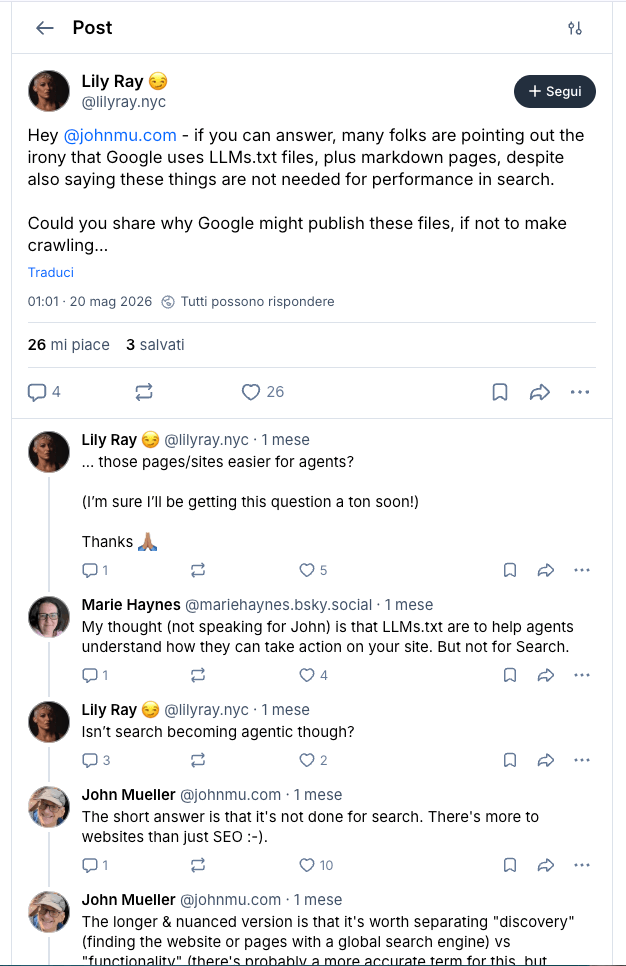
Mueller ha riconosciuto che il termine “functionality” non era preciso, ma il concetto era chiaro: lo stesso ragionamento che porta a ottimizzare la conversion rate di una pagina, che non si fa per la SEO, ma perché si è responsabili del sito nel suo complesso , si applica all’ottimizzazione per gli agenti AI.
La posizione si è ulteriormente precisata in un thread su Reddit, dove un utente aveva sollevato direttamente la questione della presunta contraddizione tra la guida Search Central e l’audit Lighthouse. Mueller ha risposto che llms.txt è “puramente speculativo per ora”, aggiungendo che il file esiste da anni senza che nessun sistema AI lo utilizzi davvero, e che personalmente preferisce l’approccio WebMCP, che ha obiettivi e processi chiari: “Dato che l’agente è già sul tuo sito, come può fare correttamente il task X?”, come ad esempio determinare il prezzo finale di un prodotto, aggiungere un articolo al carrello, compilare un modulo di contatto.
Mueller ha poi aggiunto quella che probabilmente è l’osservazione più importante dell’intera discussione: la forma più basilare di ottimizzazione per gli agenti è semplicemente assicurarsi che gli agenti non vengano bloccati nell’accedere al sito. Quell’ostacolo, a suo avviso, è più rilevante per la maggior parte dei publisher di qualsiasi discussione su llms.txt.
La posizione ufficiale di Google, quindi, si può sintetizzare in tre punti distinti:
- Per Google Search e AI Overviews: llms.txt non serve, non viene letto, non influenza il ranking. Punto.
- Per gli agenti AI operativi: la questione è aperta e speculativa. Il file potrebbe avere utilità, ma Mueller preferisce standard con obiettivi più concreti come WebMCP.
- Per qualsiasi sito: la priorità vera è non bloccare i crawler e gli agenti. Il resto viene dopo.
È questa struttura a tre livelli che rende la comunicazione di Google apparentemente contraddittoria ma internamente coerente. Due team diversi, Google Search e Chrome, stanno costruendo per scenari d’uso diversi. E come vedremo nel prossimo paragrafo, quello che Chrome sta inserendo negli strumenti di diagnosi racconta una storia piuttosto precisa su dove Google pensa che il web stia andando.
Cosa sta implementando Google nei suoi strumenti
Mentre la guida Search Central dichiarava che llms.txt non serve, un’altra parte di Google stava facendo esattamente il contrario. La sequenza temporale è precisa e vale la pena ricostruirla.
5 maggio 2026: Chrome for Developers pubblica la documentazione ufficiale dell’audit llms.txt per Lighthouse, descrivendo il file come “una convenzione emergente usata per fornire un riassunto leggibile a macchina del contenuto di un sito, progettato specificamente per LLM e agenti AI.”
7 maggio 2026: Lighthouse 13.3.0 viene rilasciato con la categoria “Agentic Browsing” spostata dalla configurazione sperimentale a quella predefinita. La categoria valuta quanto un sito sia costruito per l’interazione con le macchine attraverso un set di audit deterministici.
15 maggio 2026: Google Search Central pubblica la guida che dichiara llms.txt inutile per la Search. Dieci giorni dopo che Lighthouse ha già iniziato a controllarne la presenza su ogni sito.
9 maggio 2026: Il team Chrome conferma che WebMCP entrerà in un public origin trial in Chrome 149, collocando entrambi gli standard (llms.txt e WebMCP) su una traiettoria simile da sperimentale ad infrastruttura auditabile.
Cosa controlla esattamente Lighthouse
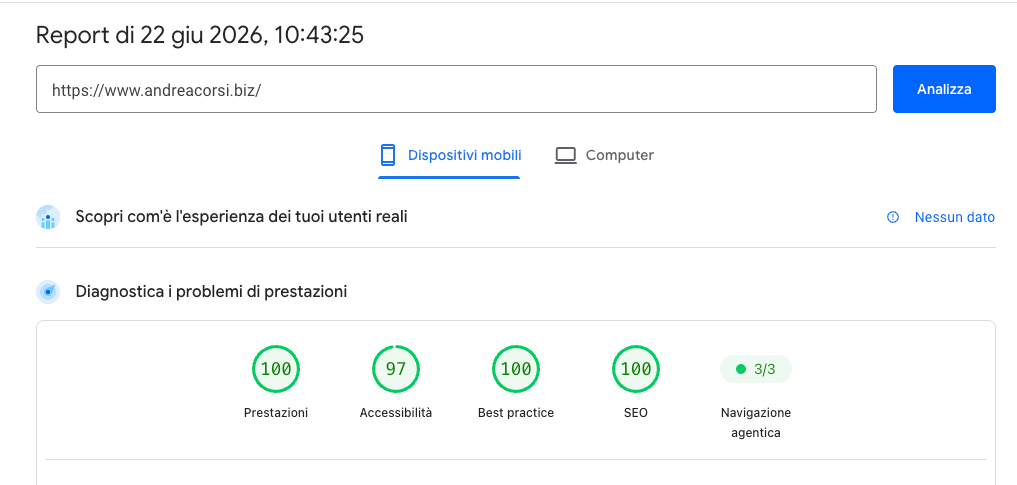
La categoria Agentic Browsing esegue audit su quattro aree: la presenza e correttezza del file llms.txt, l’integrazione WebMCP, la struttura dell’accessibility tree, e la stabilità del layout misurata tramite Cumulative Layout Shift.
A differenza delle altre categorie Lighthouse (Performance, Accessibilità, SEO, Best Practice) che producono un punteggio da 0 a 100, la categoria Agentic Browsing non genera una media ponderata, perché gli standard per il web agentico sono ancora in evoluzione. L’obiettivo attuale è raccogliere dati e fornire segnali operativi piuttosto che un ranking definitivo. Da qui il formato che vediamo su PageSpeed Insights: non un numero, ma una frazione di controlli superati — nel caso di andreacorsi.biz, 3/3.
Sull’audit specifico di llms.txt, la documentazione ufficiale Chrome è esplicita su due punti che meritano attenzione. Lighthouse segnala la pagina se si verifica un errore del server nel tentativo di recuperare il file. Se il file non è presente, restituendo un 404, l’audit viene marcato come Non Applicabile, poiché fornire il file è al momento opzionale. Non è quindi una penalità l’assenza del file: è una penalità averlo configurato male, con un server che risponde con un errore.
La documentazione Lighthouse aggiunge la motivazione pratica: “Senza llms.txt, gli agenti potrebbero impiegare più tempo per navigare il sito e comprenderne la struttura di alto livello e il contenuto principale.” Non un vantaggio SEO ma un vantaggio operativo per l’agente.
Il contesto più ampio: Google-Agent e la Search Console
L’audit Lighthouse non è un fatto isolato. Va letto insieme ad altri due segnali che Google ha emesso nello stesso periodo. Il 20 marzo 2026 Google ha aggiunto Google-Agent alla lista ufficiale dei fetcher, i sistemi che recuperano contenuti web, con uno user agent string dedicato e un file di IP range separato, dando ai proprietari di siti un modo concreto per identificare questo traffico nei log del server. È la formalizzazione di un’infrastruttura per agenti AI che naviga il web per conto degli utenti.
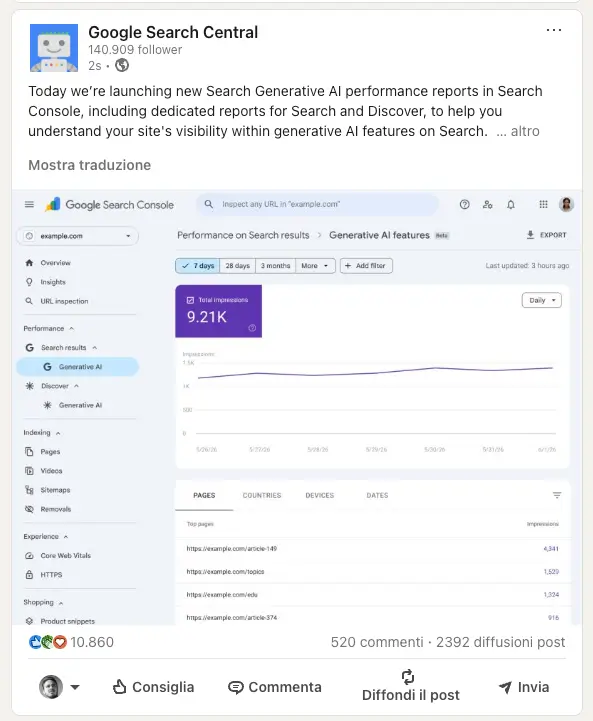
A questo si aggiunge l’annuncio del pannello AI in Search Console, atteso nei prossimi mesi, che porterà metriche specifiche sull’interazione degli agenti con i siti, dati che oggi non esistono nell’interfaccia standard. Quando quel pannello arriverà, i siti che avranno già strutturato la propria presenza per gli agenti avranno dati storici su cui ragionare. Chi inizia da zero avrà solo dati futuri.
Il quadro complessivo che emerge è coerente, anche se distribuito su prodotti diversi: Google sta costruendo un layer di infrastruttura per il web agentico in parallelo alla Search tradizionale. Lighthouse lo audita. Chrome lo esegue. Google-Agent lo popola. La Search Central, per ora, ne rimane fuori.
La distinzione che risolve la contraddizione
Se si legge la comunicazione di Google su llms.txt come un blocco unico, sembra contraddittoria. Se la si legge sapendo che proviene da due team distinti, con due missioni distinte, rivolti a due scenari d’uso distinti, diventa perfettamente coerente. La chiave è capire che Google non sta costruendo una cosa sola ma sta costruendo due layer paralleli del web, e llms.txt appartiene solo al secondo.
Il primo layer: la Search
Google Search ha già indicizzato miliardi di pagine. Ha crawler, algoritmi, grafici di conoscenza, e un’infrastruttura costruita in trent’anni per trovare, valutare e classificare contenuti. Quando un utente fa una query, testuale, vocale, o attraverso AI Overviews, Google attinge a questo indice. Il team Search ha separato chiaramente i due scenari: “discovery” significa essere trovati tramite un motore di ricerca globale. Per questo Google non ha bisogno di llms.txt, ha già tutto.
Aggiungere un file llms.txt non cambia nulla in questo layer. Google lo ha detto, lo ha scritto nella guida ufficiale, e Mueller lo ha ripetuto su Bluesky. Su questo punto non c’è ambiguità.
Il secondo layer: gli agenti
Un agente AI che naviga il web per conto di un utente opera in modo radicalmente diverso da un crawler Search. Non ha un indice precostituito. Non ha il tempo di scansionare ogni pagina. Arriva su un sito con un obiettivo preciso (prenotare un servizio, trovare un’informazione, completare una transazione) e deve capire in pochi secondi dove guardare e come muoversi.
È qui che llms.txt ha senso pratico: senza il file, gli agenti potrebbero impiegare più tempo per navigare il sito e comprenderne la struttura di alto livello e il contenuto principale. Non è un vantaggio di ranking ma è un vantaggio operativo, di efficienza, di accuratezza nell’esecuzione del task.
Mueller ha chiarito questo punto anche nel thread Reddit, usando un’analogia concreta: WebMCP, lo standard che Google preferisce per il web agentico, ha obiettivi e processi chiari: “Dato che l’agente è già sul tuo sito, come può fare correttamente il task X?” Come determinare il prezzo finale di un prodotto, aggiungere un articolo al carrello, compilare un modulo di contatto. llms.txt e WebMCP operano nello stesso layer (quello dell’agente già presente sul sito) non in quello della discovery.
La stessa logica che conosci già
C’è un parallelo utile con qualcosa che chi fa SEO conosce bene. Ottimizzare la conversion rate di una pagina non si fa per il ranking, si fa perché una volta che l’utente è arrivato, vogliamo che completi l’azione. Nessuno dice che i CTA, la UX, o la velocità di caricamento siano “fattori SEO” nel senso stretto del termine. Eppure nessun consulente serio direbbe di ignorarli.
È esattamente la distinzione che Mueller ha tracciato: si ottimizza per la discovery con la SEO, si ottimizza per la functionality con tutto il resto. E assicurarsi che un agente possa navigare il sito efficacemente rientra in quel “tutto il resto”, non nella SEO tradizionale.
Perché la comunicazione sembra contraddittoria
Il problema non è nella sostanza, è nella forma. I due team Google che hanno prodotto questi messaggi non hanno coordinato la comunicazione esterna. Google non ha commentato il gap nella documentazione tra i due team di prodotto. Il risultato è che chi legge la guida Search Central il 15 maggio e poi apre PageSpeed Insights il 16 maggio trova indicazioni apparentemente opposte sullo stesso file.
Per chi lavora nel settore, la distinzione è importante da interiorizzare, non solo per capire cosa fare oggi, ma per saper rispondere ai clienti quando arriveranno con la stessa domanda. La risposta corretta non è “Google dice che non serve” né “Google dice che serve”. La risposta corretta è: per quale scenario stiamo ottimizzando?
Se l’obiettivo è comparire in AI Overviews o AI Mode, llms.txt non è il file da toccare. Se l’obiettivo è preparare il sito per un web in cui gli agenti AI navigano, prenotano e acquistano per conto degli utenti, il file è uno dei segnali che Lighthouse già misura, e che Google-Agent già incontra quando visita i siti.
Sono due domande diverse. Richiedono risposte diverse. E Google, con qualche difficoltà comunicativa, sta cercando di risponderle entrambe nello stesso momento.
Cos’è la navigazione agentica e i tre requisiti di Lighthouse
La navigazione agentica è il modo in cui un agente AI, un sistema autonomo che agisce per conto di un utente, interagisce con un sito web. Non legge il sito come lo legge un umano, non lo indicizza come fa Googlebot. Lo usa: clicca elementi, compila form, naviga tra sezioni, recupera informazioni per completare un task specifico.
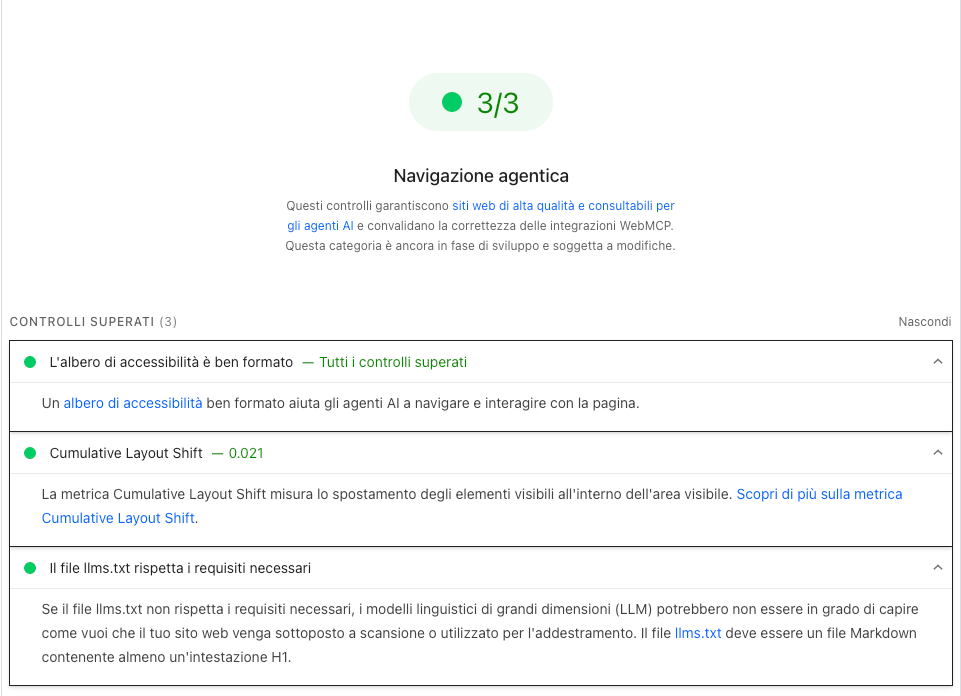
Lighthouse valuta questa capacità attraverso un set di audit deterministici raggruppati nella categoria Agentic Browsing, introdotta nella versione 13.3.0 del 7 maggio 2026 come parte della configurazione predefinita. A differenza delle altre categorie (Performance, Accessibilità, SEO) non produce un punteggio da 0 a 100 ma una frazione di controlli superati, perché gli standard per il web agentico sono ancora in definizione.
I tre controlli che vediamo su PageSpeed Insights sono questi.
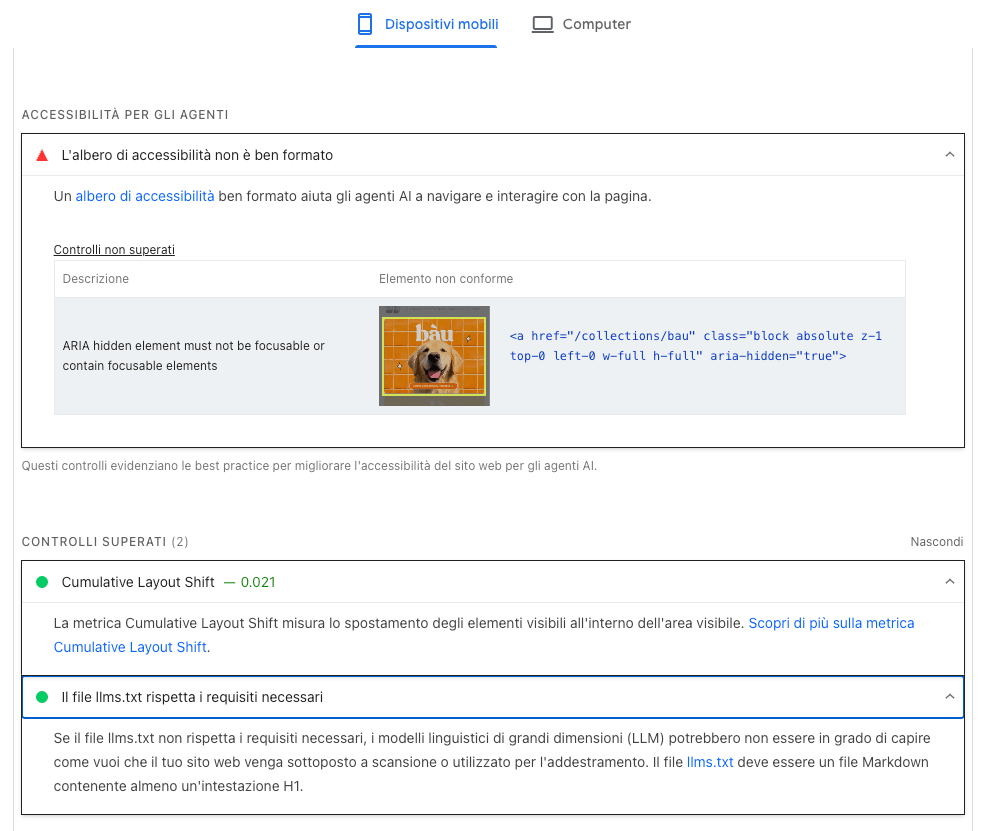
Albero di accessibilità ben formato
L’albero di accessibilità è una rappresentazione strutturata della pagina che il browser costruisce parallelamente al DOM, non per gli utenti, ma per i sistemi che interagiscono con la pagina in modo programmatico: screen reader, strumenti assistivi, e appunto agenti AI.
Lighthouse specifica che gli agenti utilizzano l’albero di accessibilità come loro modello di dati primario. Se quell’albero è mal formato (elementi interattivi senza etichette, struttura gerarchica incoerente, contenuti nascosti agli strumenti assistivi) l’agente non riesce a navigare la pagina in modo affidabile. Non è un requisito nuovo: è lo stesso lavoro sull’accessibilità semantica che chi fa SEO tecnica conosce già, semplicemente letto da una prospettiva diversa.
Cumulative Layout Shift
Il CLS è una metrica Core Web Vitals che misura la stabilità visiva della pagina durante il caricamento: quanto gli elementi si spostano in modo inatteso prima che la pagina si stabilizzi. Per un agente che deve interagire con un elemento specifico (un pulsante, un form, un link) uno spostamento del layout nel momento sbagliato significa cliccare l’elemento sbagliato o non trovarlo affatto.
Per agenti che completano task per conto degli utenti come prenotazioni, acquisti o compilazione di moduli, non è un’inconvenienza minore: è un fallimento del task. La soglia che Lighthouse considera accettabile è un CLS inferiore a 0.1.
Il file llms.txt rispetta i requisiti necessari
Come abbiamo visto nei paragrafi precedenti, Lighthouse non penalizza l’assenza del file ma la marca come Non Applicabile. Penalizza invece un file configurato male, con un server che risponde con un errore quando il file viene richiesto. I requisiti minimi che Lighthouse verifica sono tre: il file deve essere raggiungibile, deve essere Markdown, deve contenere almeno un’intestazione H1. Tutto il resto, sezioni, link annotati, profondità dei contenuti, è ottimizzazione, non requisito minimo.
Vale la pena implementarlo?
La risposta breve è sì, con una distinzione importante su come e quanto investirci in base alla piattaforma che si utilizza.
Il costo di implementazione è basso. Il file è un documento Markdown statico alla root del dominio. Non richiede infrastruttura, non rallenta il sito, non interferisce con nessun sistema esistente. Il rischio è zero. L’upside (essere già strutturati per un web in cui gli agenti navigano, confrontano e acquistano per conto degli utenti) è reale anche se i tempi non sono ancora definiti.
Se hai un e-commerce Shopify
Shopify genera automaticamente il file llms.txt su tutti gli store. Puoi verificarlo aggiungendo /llms.txt o /llms-full.txt al dominio del tuo negozio. Il file prodotto da Shopify non è una mappa editoriale del sito ma è un’interfaccia funzionale per agenti: descrive i flussi operativi dello store, gli endpoint disponibili, le modalità di navigazione per aggiunta al carrello, checkout e gestione ordini.
È un approccio radicalmente diverso da quello dei CMS editoriali, e racconta molto su come Shopify immagina il futuro del commercio agentico. Ho approfondito questo aspetto, e cosa contiene concretamente il file agents.md di Shopify, in un articolo dedicato: llms.txt e agents.md su Shopify: SEO agentica per e-commerce.
Se hai un sito WordPress
Hai due strade. La prima è creare il file manualmente seguendo la specifica ufficiale su llmstxt.org. Bastano un editor di testo e accesso alla root del dominio via FTP o file manager.
La seconda, più pratica per chi gestisce siti con molti contenuti, è usare un plugin come Rank Math, che genera il file in automatico attingendo a pagine, post e Custom Post Type del sito. Il valore aggiunto di Rank Math rispetto alla generazione automatica è la possibilità di intervenire manualmente: aggiungere sezioni descrittive, contestualizzare il posizionamento del sito, inserire link a risorse esterne verificabili come profili social o directory di settore.
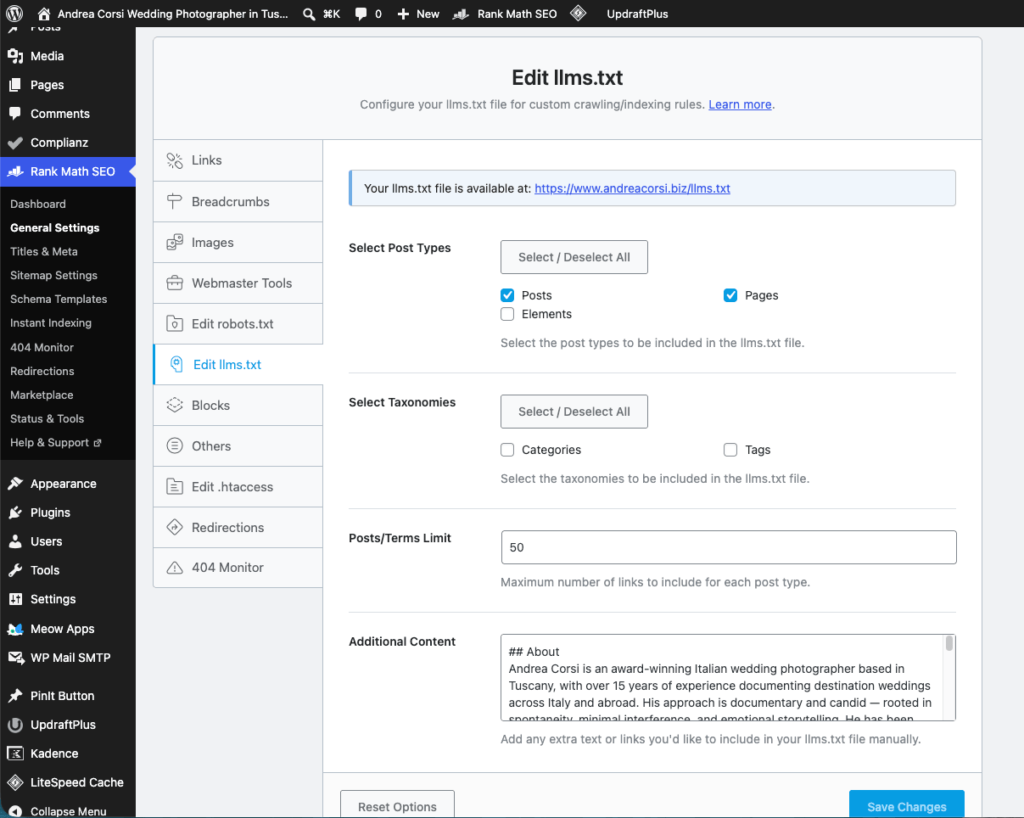
Il risultato finale non è un file per Google Search. È un documento che racconta chi sei, cosa fai e come sei strutturato a qualsiasi sistema che arriva sul tuo sito con un obiettivo da completare. Oggi quegli sistemi sono ancora pochi e il loro comportamento è in evoluzione. Ma l’infrastruttura che li accoglie si costruisce prima che arrivino, non dopo.

